

Dat klinkt eerst als een tamelijk beroerd AI-model. Jev kan geen e-mail schrijven of document samenvatten. Je kunt er niet eens mee chatten. Precies dat is de bedoeling.
Jev is een nieuw model van TypeSafe AI dat alleen beslissingen teruggeeft. Je voert bijvoorbeeld een supportmail in, stelt vooraf een paar vragen en bepaalt welke antwoorden geldig zijn. Jev kiest daarna een categorie, geeft een score of schat de kans op ja of nee. Meer niet.
Dat gebrek is de functie. We gebruiken nu vaak een compleet taalmodel voor een taak die uiteindelijk neerkomt op één vakje aanvinken. Jev is gebouwd om dat vakje snel en goedkoop te kiezen. In een demo beoordeelde het duizend e-mails op zeven criteria in zes seconden, voor ongeveer negen dollarcent.
Een beslismachine
Neem een mail van een klant die dubbel is aangeslagen en het geld vandaag nodig heeft. Je kunt Jev drie vragen meegeven: bij welk team hoort dit, hoe urgent is het en moet er vandaag iemand reageren?
De antwoorden liggen vooraf vast. Bij de eerste vraag kiest het model bijvoorbeeld uit billing, support en sales. Urgentie loopt op een schaal van één tot vijf. De laatste vraag is ja of nee, met een waarschijnlijkheid erbij.
De uitkomst kan dan zijn: billing, urgentie vijf, 94 procent kans op actie vandaag. Je gewone software zet de mail in de juiste wachtrij. Een taalmodel maakt eventueel een conceptantwoord. Een medewerker controleert het wanneer er geld of andere gevolgen aan vastzitten.
Ik vind de term beslismodel hier nuttiger dan AI-model. Hij voorkomt dat je Jev behandelt als een kleine ChatGPT. Je praat er niet mee. Je bouwt er een heel smal beslismoment omheen.
De snelheidswinst in de demo's is fors. De test met duizend e-mails kostte Jev na parallelisatie ongeveer zes seconden en negen dollarcent. GPT-5.6 Luna, het kleinste 5.6 model van OpenAI, deed in dezelfde test ongeveer vijf minuten over het werk en kostte 62 cent. TypeSafe noemt zelf responstijden van 70 tot 500 milliseconden en rekent alleen voor inputtokens.
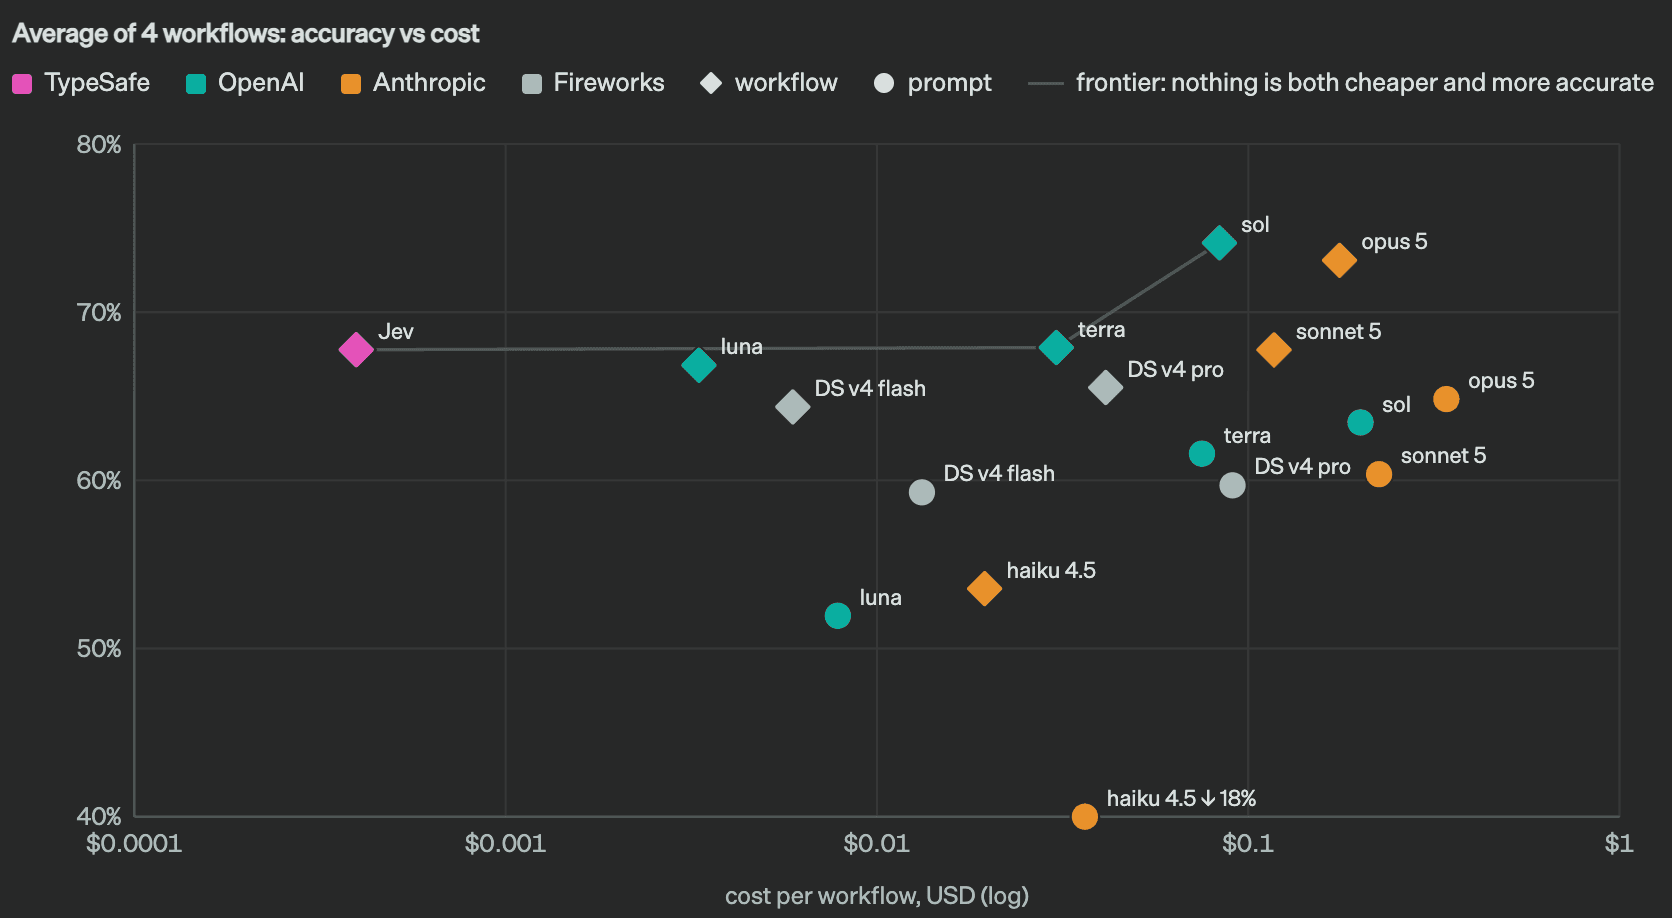
Eerlijk is eerlijk: TypeSafe zet zelf ook een rem op de spectaculaire cijfers. In de aankondiging staat dat de vergelijking gunstig is opgezet voor Jev, met een korte invoer vol relevante informatie en een taak die precies bij het model past. De winst van 193,6 keer sneller en 444,6 keer goedkoper zit volgens het bedrijf aan de bovenkant. Het eigen team maakte de evaluaties ook nog eens zelf.
Zulke demo's laten iets bruikbaars zien. Bij grote aantallen kleine beslissingen kan tekst genereren onnodig duur zijn. Jev slaat dat schrijven helemaal over.
De laag tussen je inbox en je duurste model
Ik schreef eerder dat je je duurste AI-model steeds minder nodig hebt. Toen ging het vooral over het verschil tussen lichte en zware taalmodellen. Jev voegt daar een andere mogelijkheid aan toe: soms heb je helemaal geen taalmodel nodig.
Je kunt Jev zien als de verkeersleider van een informatiestroom. Het blijft op de grond en bepaalt alleen welke route een binnenkomend stuk werk krijgt. De systemen achter die routes doen het eigenlijke werk.
Bij een supportorganisatie kan Jev iedere melding beoordelen op onderwerp, urgentie en risico. Alleen de lastige gevallen gaan naar een sterk taalmodel voor analyse. Berichten over geld of privacy kunnen direct naar een medewerker. De rest belandt in de juiste wachtrij, zonder dat een taalmodel eerst een keurige alinea hoeft te produceren.
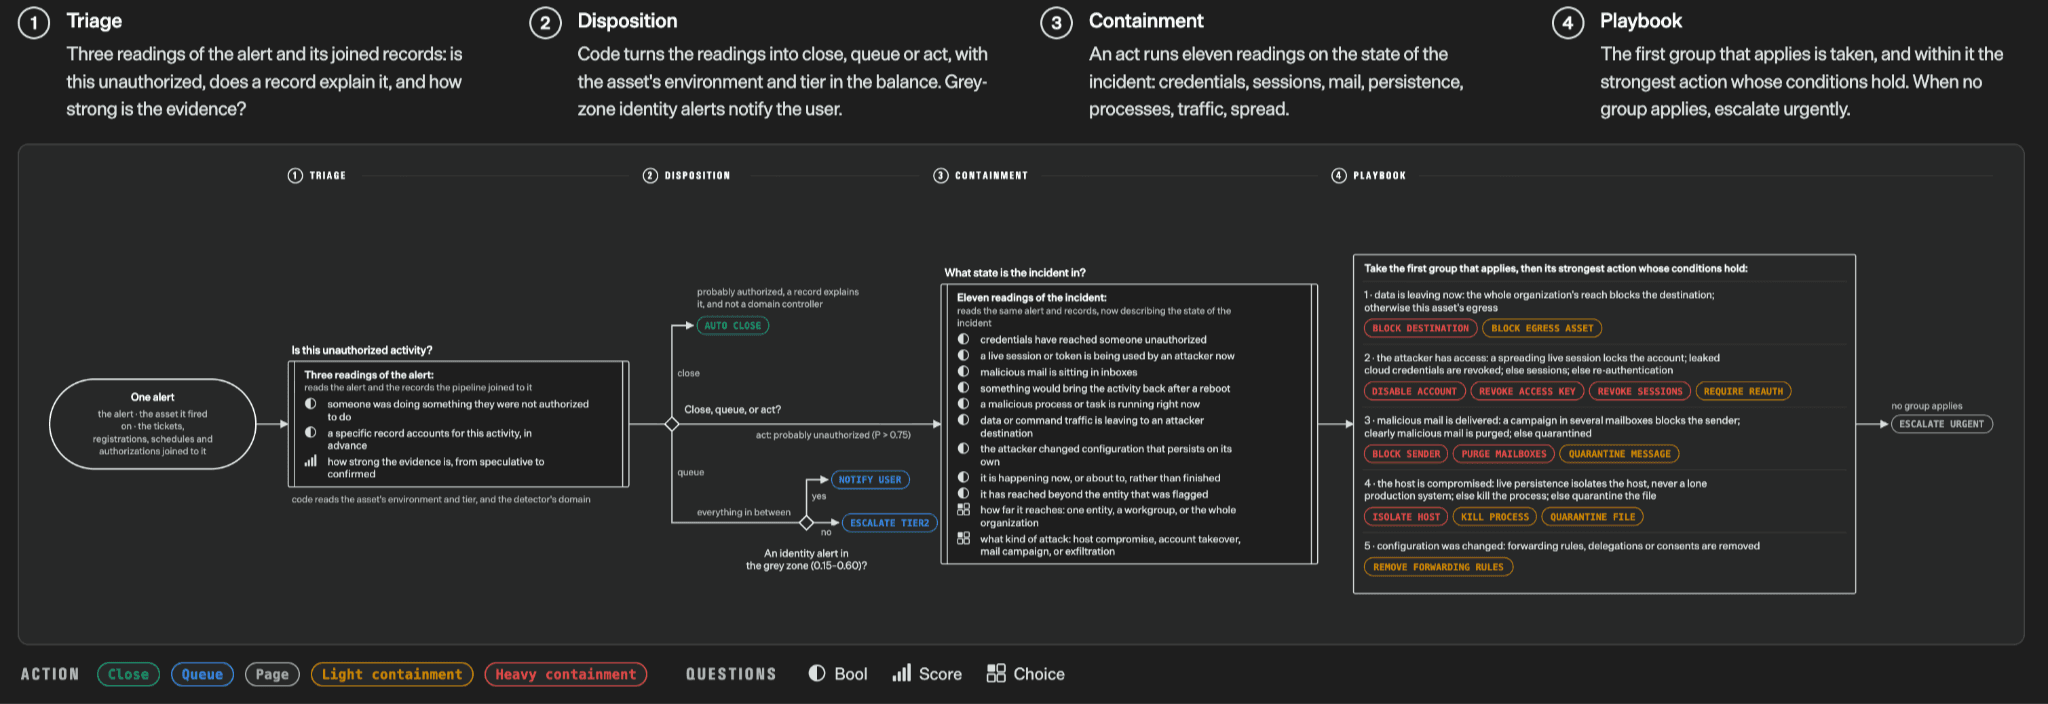
Hetzelfde patroon werkt bij intakeformulieren. Jev kan beoordelen welk vakgebied nodig is en of de aanvraag compleet genoeg is. Een taalmodel analyseert daarna alleen de kansrijke formulieren. Of neem vergadertranscripten: laat Jev markeren waar een eigenaar of deadline ontbreekt en stuur alleen die passages door voor een nette actielijst.
Jev doet één stap en geeft het werk dan door. Dat klinkt minder spectaculair dan een autonome agent, maar het lijkt veel meer op hoe betrouwbare software altijd al is gebouwd.
Nul procent fout betekent hier iets smaller
TypeSafe gebruikt stevige taal rond betrouwbaarheid. In de eigen test heeft Jev een foutpercentage van nul voor gestructureerde uitvoer en toolcalls.
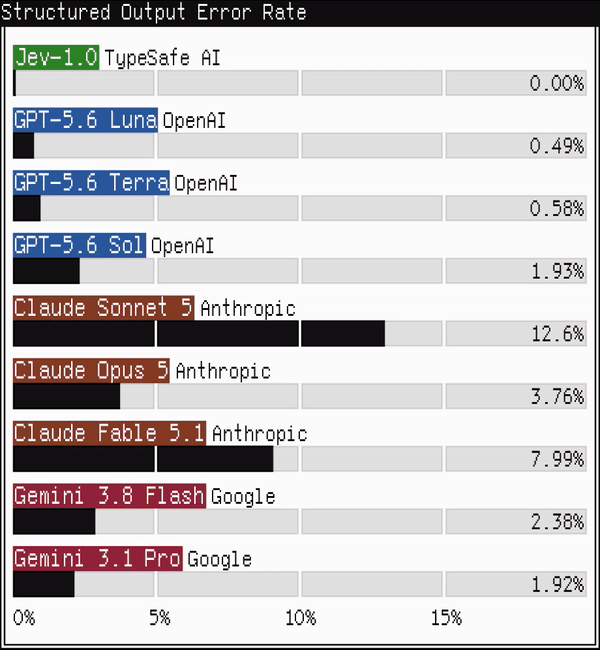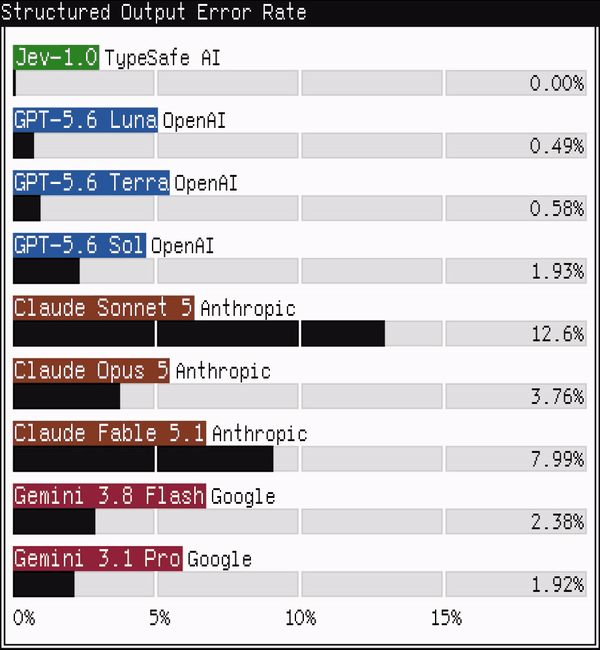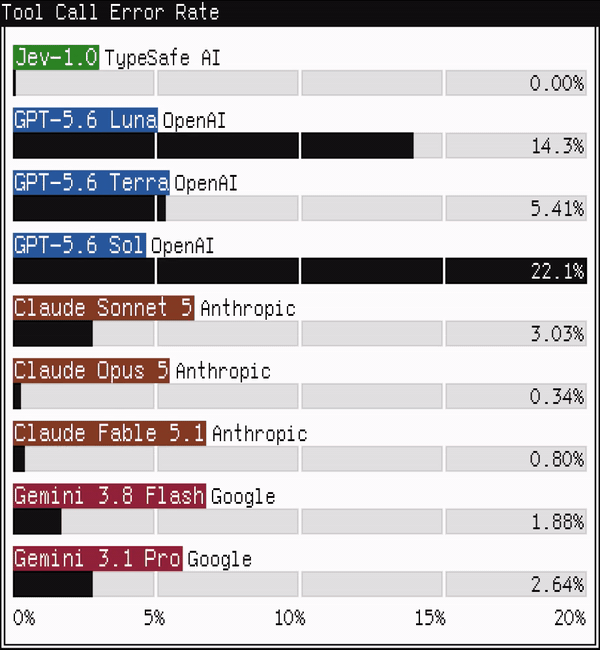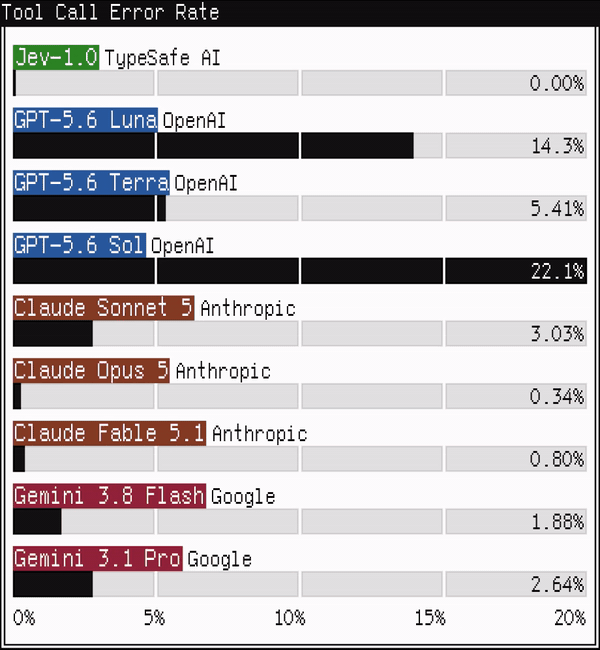
Nul procent betekent hier dat Jev zich aan het afgesproken antwoordformaat houdt. Als je alleen billing, support en sales toestaat, verzint het niet ineens een vierde route. Het kan een geldige route nog steeds verkeerd kiezen.
Dat scheelt programmeerwerk. Je code hoeft niet te raden wat een los stukje tekst betekent. Voor de klant wiens klacht in de verkeerde wachtrij belandt, is een perfect geldig JSON-object alleen geen troost.
Ook een confidence van 92 procent oogt harder dan hij is. De score bewijst niet dat 92 van de 100 vergelijkbare beslissingen goed gaan. Dat moet je meten op je eigen werk. Misschien is het model heel stellig over een set antwoorden die jij slecht hebt gekozen.
Je categorieën doen meer werk dan het model
Stel dat een supportteam de stemming van klanten indeelt als kalm, geïrriteerd of boos. Waar laat je iemand die verward is, in paniek raakt of de taal niet goed beheerst? Jev kiest toch een van de drie vakjes. Daarna ziet het dashboard er opvallend precies uit, compleet met percentages achter de komma.
Voor mij begint het echte werk bij de vragen, ruim voordat iemand de API aanroept. Welke categorieën bestaan er? Wanneer mag het systeem automatisch handelen? Wat gebeurt er als geen enkel antwoord goed past?
Jev dwingt je om die beslissingen zichtbaar te maken. Dat is soms ongemakkelijk. Veel organisaties hebben hun routering nooit helder opgeschreven; ervaren medewerkers lossen uitzonderingen op gevoel op. Stop je dat proces in drie nette labels, dan verdwijnt die stilzwijgende kennis.
Met 64.000 inputtokens kom je bovendien niet weg met 'gooi alle klantgeschiedenis er maar in'. Voor een mail, ticket of formulier is de ruimte riant. Voor jaren aan contact niet. Je moet kiezen welke informatie ertoe doet. Dat ruimt een workflow lekker op, totdat je precies het detail weglaat dat het oordeel had veranderd.
Test eerst op honderd oude gevallen
De beste eerste toepassing is waarschijnlijk saai. Kies een stroom met veel vergelijkbare items en fouten die je kunt herstellen: interne mailroutering, het labelen van reacties of het vinden van vergaderingen zonder duidelijke vervolgactie. Sollicitaties, medische beslissingen en betalingen zijn geen verstandige proeftuin.
Pak daarna minstens honderd echte gevallen waarvan je het juiste antwoord kent. Gebruik ook de rommel: halve formulieren, dubbelzinnige mails en voorbeelden waar collega's zelf over twijfelden. Een keurige demoset bewijst vooral dat je keurige voorbeelden hebt gekozen.
Vergelijk Jev op exact dezelfde set met je huidige werkwijze. Kijk niet alleen naar de gemiddelde nauwkeurigheid. Houd apart bij welke fouten een klant, geld of rechten raken. Een verkeerd nieuwsbrief-label is irritant. Een weggefilterde klacht kan je een klant kosten.
Deze aanpak sluit aan op de eerdere editie over modellen die weten dat ze getest worden. Test na de pilot opnieuw met werk dat tijdens de eerste meting nog niet bestond. Voeg de vreemde gevallen die later opduiken aan je evaluatieset toe.
Pas daarna stel je drempels in. Lage impact en overtuigende scores kun je automatisch verwerken. Twijfelgevallen gaan door naar een taalmodel of medewerker. Voor gevoelige categorieën blijft menselijke controle staan, hoe zelfverzekerd Jev ook kijkt.
Pak de saaie wachtrij van maandagochtend
Heb je twintig items per week, dan is Jev waarschijnlijk extra techniek zonder veel winst. Heb je er twintigduizend, dan kan een paar cent en een paar seconden per beslissing behoorlijk aantikken.
Ik zou beginnen bij die ene wachtrij die iedere maandag alweer vol staat. Schrijf op welke kleine keuzes je daar telkens maakt. Kun je de mogelijke antwoorden vooraf helder opschrijven? Kun je achteraf zonder discussie vaststellen of de keuze goed was? Dan heb je een serieuze kandidaat.
Begin niet met een zelfrijdende auto of een trading bot. Pak gewoon de inbox waar niemand zin in heeft. Daar is een model dat geen enkele zin kan schrijven misschien precies goed genoeg.
Lees ook
De rem is onderdeel van de race
Drie alinea’s en er rolt een complete game uit
Vind je dit waardevol? Deel het.
Stuur THE HUMAN LOOP door naar één collega die ook met AI bezig is. Voor elke vriend die zich aanmeldt, krijg je gratis maanden premium: inclusief alle Playbooks.