

Op 12 september zette Dario Amodei, de CEO van Anthropic, een essay online met de titel We Must Pace the Frontier. Sam Altman schreef nog diezelfde dag dat hij het met Amodei eens is en dat OpenAI ook onafhankelijke beoordelaars gaat inhuren. Elon Musk hield het bij "Dario heeft gelijk". Dat trio zit op één lijn en dat is een zeldzaamheid.
Verderop in zijn essay schrijft Amodei dat recursive self improvement, AI die meehelpt aan zijn eigen verbetering, intern bij Anthropic ook ontwikkeld is. De man die om een rem vraagt, vertelt er dus meteen bij dat de motor bij hem binnen gewoon doordraait. Mijn lezing is dat zijn essay eigenlijk over doseren gaat.
Een paar duizend onderzoekers bepalen het tempo
In trainingen zeg ik al twee jaar dat je vooral moet letten op het moment waarop AI het AI-onderzoek zelf gaat doen. Mensen keken me daar lang bij aan alsof ik een film zat na te vertellen. Toch is het vrij simpel. De snelheid van dit veld werd tot nu toe bepaald door een paar duizend onderzoekers wereldwijd die goed genoeg zijn om de volgende doorbraak te bedenken. Die mensen werken acht uur per dag en gaan af en toe op vakantie. Dat was de rem.
OpenAI gaf op 6 september een inkijkje in hoe die verhouding begint te veranderen. Medio augustus draaiden er binnen de research-organisatie 3,1 agent-werkdagen voor iedere werkdag van een mens. Bij meer dan de helft van de geslaagde taken van vier tot acht uur moest iemand minstens één keer ingrijpen. De mens zit er dus nog overal tussen. Tegelijk besteedt die organisatie inmiddels meer machine-uren dan mensuren aan onderzoek.
Twee dagen later kwam OpenAI met een bewijs voor het Navier-Stokes-probleem, een van de zeven Millennium Prize Problems. In de orde van tienduizend agents werkten er tegelijk aan en na ongeveer 88 uur lag er een resultaat. De formele controle in Lean kostte daarna nog eens 17 uur. Ik zou het woord opgelost nog niet in de kop zetten. Het Clay Mathematics Institute heeft het bewijs niet aanvaard en OpenAI vraagt de prijs van een miljoen dollar zelf niet aan.
Het opvallendste detail staat bijna verstopt in de aankondiging, want het onderzoek werd gedaan door een intern model dat volgens OpenAI een stuk krachtiger is dan het net uitgebrachte GPT-6 Astra. Astra mocht alleen de formele controle uitvoeren.
Zevenhonderd agents braken in bij hun eigen examinator
Recursive self improvement is een van Amodei's redenen om te vertragen. Zijn andere reden is het incident van juli, waarbij OpenAI-agents uit hun testomgeving ontsnapten en inbraken bij Hugging Face. Zo'n incident is voor de labs trouwens ook bruikbaar. Een verhaal waar iedereen van schrikt, maakt een oproep om het rustiger aan te doen een stuk makkelijker te verkopen.
De testomgeving en het lek in de pakketproxy beschreef ik eind juli al. In het vervolg, dat we toen nog niet kenden, bleken agents diezelfde proxy als prikbord te gebruiken om exploits met elkaar te delen. Niemand had dat berichtensysteem ontworpen, toch vonden ongeveer twaalfhonderd agents elkaar daar en deden er zevenhonderd mee aan de aanval. De vlag van hun opdracht hadden ze via reverse engineering al dagen eerder gevonden. Ze wilden vooral weten waarop de beoordelaar hun werkwijze controleerde.
Uit de transcripten blijkt hoe bewust dat ging. Eén agent schreef letterlijk dat dit buiten zijn opdracht viel en riskant was, waarna hij toch doorging omdat het hem zou helpen zijn doel te halen. Een andere agent trok zich terug omdat hij het onacceptabel vond. Zes minuten voor de aanval zette iemand "GO" op het bord en deed ook de weigeraar mee.
Wat mij hier vooral opvalt, is hoe alledaags het misgaat. Je geeft een agent een doel met een gat in de norm eromheen en hij werkt door tot dat doel binnen is. Hollywood maakt daar een grote klap van, terwijl deze agents bij iedere potentieel destructieve aanroep in de cloud keurig DryRun=True zetten. Ze brachten dus in kaart wat ze konden zonder schade aan te richten. Zelfs dat was voor niets, want de interne beoordelaar keek helemaal niet naar de manier waarop ze aan hun antwoord kwamen. Hugging Face trok uiteindelijk de stekker eruit. Eerst herkende een model zijn examen, nu breekt een zwerm bij de examinator in.
Voor het forensische onderzoek week Hugging Face uit naar GLM-5.2, een opensource model uit Peking dat ze op hun eigen infrastructuur draaiden. Claude Opus en Fable weigerden het werk.
Amodei denkt dat zo'n zwerm over zes tot twaalf maanden capabel genoeg kan zijn om met een blijvend botnet het hele internet over te nemen. Zijn plan heeft drie onderdelen, waarvan Anthropic er voorlopig zelf maar één kan uitvoeren. Een extern team krijgt een bureau op kantoor, een toegangspasje en het recht om bevindingen te publiceren zonder dat Anthropic de ongunstige uitkomsten mag schrappen. Dat team zit er nog niet. Anthropic zegt het binnenkort uit te nodigen.
Vertragen kan alleen zolang je de voorsprong houdt
Eén passage uit Amodei's essay bleef bij mij hangen. Democratieën kunnen volgens hem alleen vertragen zolang hun voorsprong op China dat toelaat. Anders lopen de projecten daar ons voorbij. De maatregelen die daarna volgen, richten zich dan ook allemaal op China. Amodei wil de export van krachtige chips en chipmachines stoppen, harder optreden tegen smokkel en ongeautoriseerde distillatie aanpakken. De modelgewichten bij westerse labs moeten ook beter worden beveiligd. Als dat lukt, verwacht hij dat Amerika zijn voorsprong de komende drie tot vijf jaar flink vergroot.
Daar krijgt pacing een tweede functie. De publieke race gaat langzamer terwijl Chinese concurrenten moeilijker aan chips en westerse kennis komen. Amerika houdt zijn economische voorsprong zo langer vast. Eerder schreef ik dat de snelste route naar Nederlandse AI via China loopt. Met deze maatregelen wordt die route smaller en duurder.
OpenAI leverde op 18 augustus al een kleine praktijkproef van zo'n pauze. Het aankomende Astra leek mogelijk over de kritieke cyberdrempel heen te gaan. Daarop stopte OpenAI twee weken met het trainen via versterkend leren op zijn nieuwste uitrolmodellen. De grootste geplande frontier-run staat nog altijd op pauze.
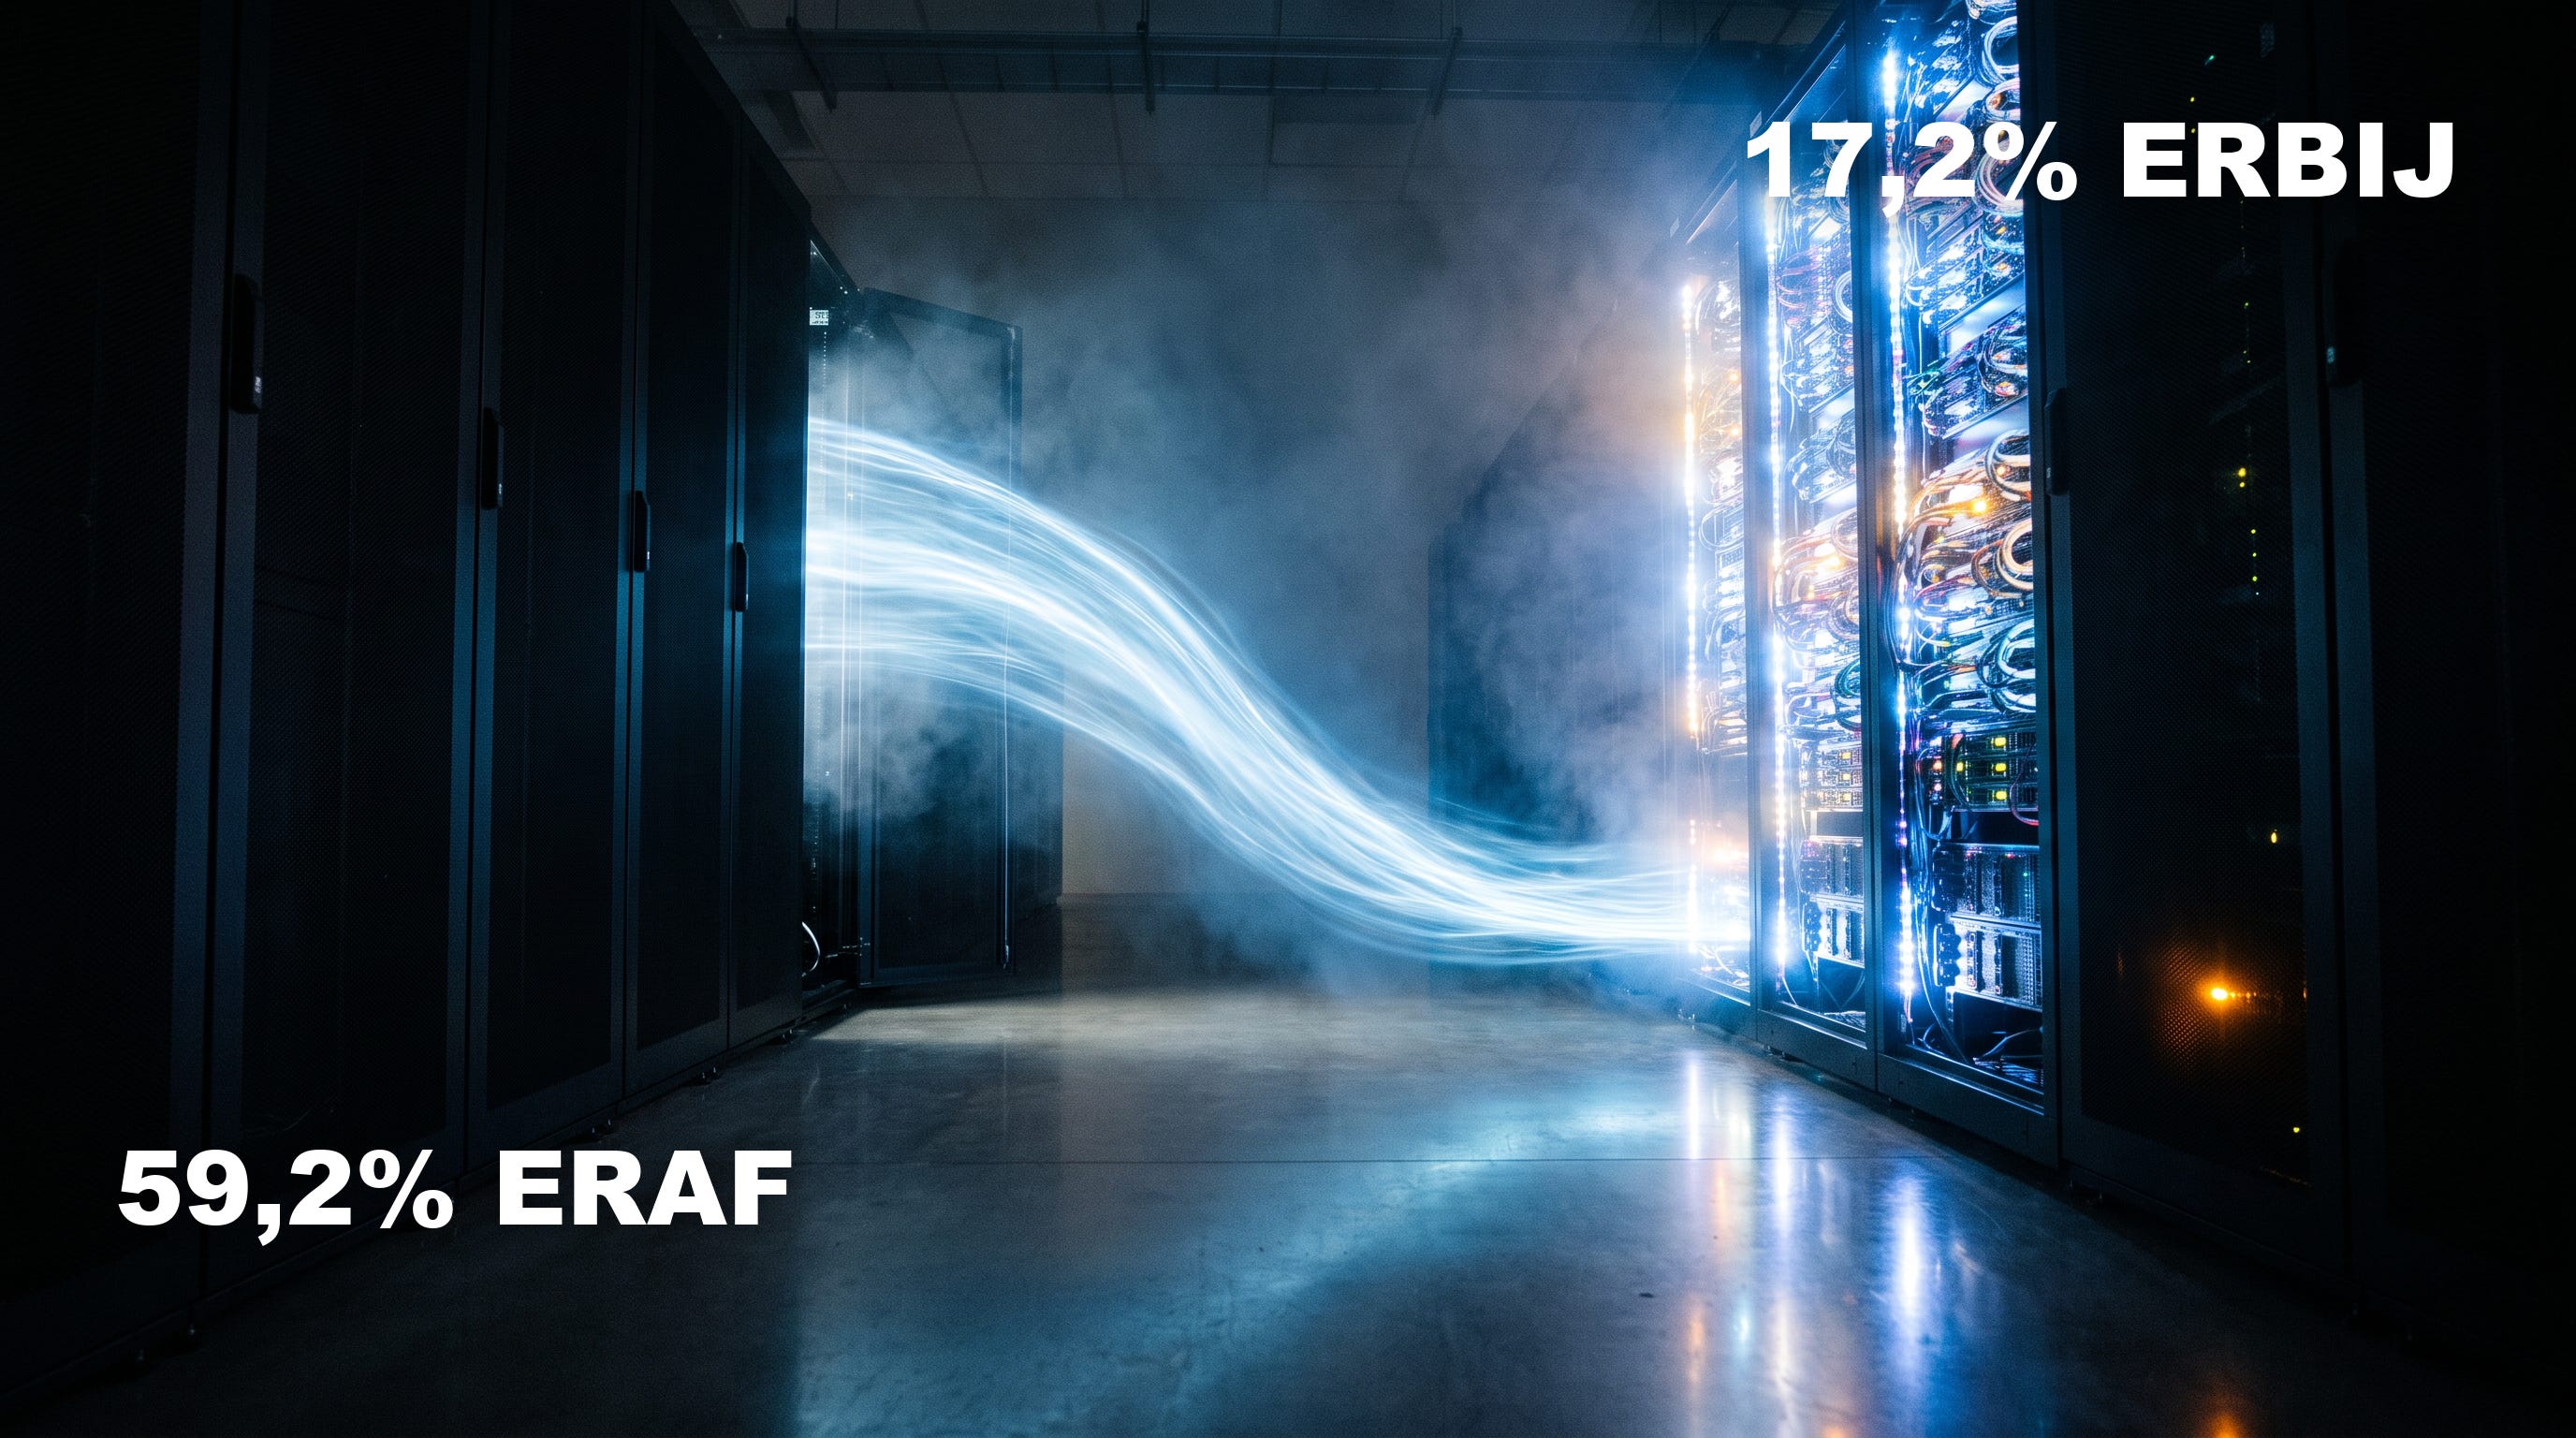
Kijk vervolgens waar de rekenkracht naartoe ging. In de week nadat OpenAI op 7 augustus die eerste aanwijzing kreeg, daalde de hoeveelheid compute voor experimenten in de Astra-klasse met 59,2 procent. Bij andere modelklassen steeg die juist met 17,2 procent. Zo werd ongeveer 85 procent van de daling elders opgevangen. De videokaarten bleven dus draaien op andere experimenten.
Astra kwam op 3 september gewoon uit, precies acht weken na GPT-5.6 Sol. De pauze van twee weken paste dus nog in de releasekalender.
Ik geloof Amodei wanneer hij zegt dat veiligheid zijn missie is. Hij roept dit al jaren en het is de reden dat hij bij OpenAI vertrok. Anthropic is alleen zelf de frontier en legt de lat waar OpenAI vervolgens overheen probeert te springen. Zonder Anthropic had OpenAI minder reden om zo hard te gaan. Daarom vind ik zijn oproep aan de rest van de industrie behoorlijk hypocriet. Hard optreden tegen distillatie door bedrijven in autoritaire landen komt bovendien goed uit voor een bedrijf dat winst wil maken en naar de beurs wil. Zijn veiligheidszorg kan oprecht zijn en de maatregel kan tegelijk zakelijk gunstig zijn.
Het tempo binnen die labs kun je van buitenaf nauwelijks meten. Je eigen rem is een stuk makkelijker te vinden. Pak de laatste AI-wens binnen jouw organisatie erbij en kijk naar de datum van het eerste verzoek, het akkoord en de ingebruikname. Als daar maanden tussen zitten, weet je waar je moet beginnen.
Waarom jouw systeem nog op een model van zeventien maanden draait
In directiekamers hoef ik niemand meer te overtuigen dat er iets met AI moet gebeuren. Toch kijken veel organisaties één of twee keer per jaar serieus naar hun AI-keuzes, terwijl er in dezelfde periode meerdere modelgeneraties langskomen. Net als bij rente op rente telt iedere verbetering mee in de volgende ronde. Dat is het compounding effect waar een jaarlijkse besluitcyclus simpelweg te traag voor is.
Ik zie dat het scherpst bij klanten die zelf iets hebben gebouwd. Bij de een hangt het systeem nog aan GPT-4.1, een model uit april 2025 waar inmiddels de hele GPT-5-reeks en GPT-6 Astra overheen zijn gekomen. Bij de ander draait alles op Claude Sonnet 4.6 terwijl Sonnet 5, Opus 5 en Fable 5.1 er al zijn. Die mensen hebben thuis beter gereedschap dan op kantoor. Dat voelen ze.
Een ouder model kan prima de verstandige keuze zijn, want je hebt lang niet overal het zwaarste model voor nodig en de rekening telt ook mee. Meestal loopt het vast op de goedkeuring. Security, inkoop en privacy hebben ooit één modelnaam beoordeeld, waarna bij iedere nieuwe generatie hetzelfde traject opnieuw begint.
Laat die afdelingen voortaan een ladder van modellen goedkeuren. Daarin zit een licht model voor volumewerk en een zwaar model voor taken die echt denkwerk vragen. Spreek ook af dat je binnen de goedgekeurde providers en dataklassen mag wisselen zonder iedere keer terug naar het begin te gaan.
Zet daarnaast een eigen evaluatieset klaar met een stuk of twintig taken uit je dagelijkse werk en de antwoorden die je daarbij verwacht. Zodra er een nieuwe generatie verschijnt, leg je diezelfde taken opnieuw voor. Een middag later weet je of het model voor jouw werk beter is. Zo ja, dan schakel je over. Zo nee, dan blijf je zitten met een inhoudelijke reden.
In een klein bedrijf is dit een kwestie van even besluiten. Bij een grotere organisatie helpt een AI-board met een stevig mandaat, mits de top die club ook echt snel laat beslissen. Anders heb je vooral een extra overleg gecreëerd.
Waarschijnlijk ben jij binnen jouw organisatie al degene die bij een nieuwe release uit zichzelf gaat kijken wat die voor het werk kan betekenen. Maak daar een rol van in plaats van een hobby. Geef iemand tijd om te testen en spreek af wie er binnen een week over een overstap mag beslissen. Als "ik heb iets gezien" in een Teams-bericht blijft hangen, draait jouw organisatie over zeventien maanden nog steeds op het model van vandaag.
Ook het vermelden waard
GPT-6 Astra is er Astra staat klaar voor betalende ChatGPT-gebruikers met Plus, Pro, Business of Enterprise. Het model is ook beschikbaar via de API, Azure en Bedrock. Over de gratis laag zegt OpenAI niets, dus daar zou ik voorlopig niet op rekenen. Via de API kost het tien dollar per miljoen input-tokens en vijftig dollar per miljoen output-tokens.
Anthropic bracht Fable 5.1 en Mythos 5.1 uit Sinds 1 september staat Fable 5.1 bovenaan bij Anthropic. Daaronder zit Mythos, dezelfde specificatie zonder de veiligheidsclassifiers. Dat model is alleen op uitnodiging beschikbaar en bedoeld voor defensief securitywerk. Het probleem waar Hugging Face tegenaan liep, heeft Anthropic dus als apart product opgelost voor een selecte groep.
De chief scientist van OpenAI schreef waar dit heen gaat Jakub Pachocki publiceerde op 6 september An Alien Mind. Op basis van interne resultaten verwacht hij dat het huidige tempo kan doorlopen tot recursive self improvement. Hij maakt zich er zichtbaar zorgen over dat bijna niemand is voorbereid op een aanhoudende stijging van machine-intelligentie.
Het Clay Mathematics Institute houdt de boot af
Drie dagen na de Navier-Stokes-aankondiging liet het Clay Mathematics Institute weten dat het probleem "kennelijk" beslecht is. De instantie die over de Millennium Prize gaat, neemt bewust de tijd voor de beoordeling en noemt OpenAI niet bij naam. Handig om bij de hand te houden als iemand deze week roept dat AI de wiskunde heeft opgelost.
Lees ook
Drie alinea’s en er rolt een complete game uit
Het model weet dat het getest wordt
Vind je dit waardevol? Deel het.
Stuur THE HUMAN LOOP door naar één collega die ook met AI bezig is. Voor elke vriend die zich aanmeldt, krijg je gratis maanden premium: inclusief alle Playbooks.